阿里云镜像快速构建springboot
发表于|更新于
|浏览量:
智者弃短取长,以致其功。——《后汉书·王符传》
我们创建springboot项目时如果使用原来的https://start.spring.io构建会很慢
这里我们可以使用阿里云的脚手架地址
1 | https://start.aliyun.com |
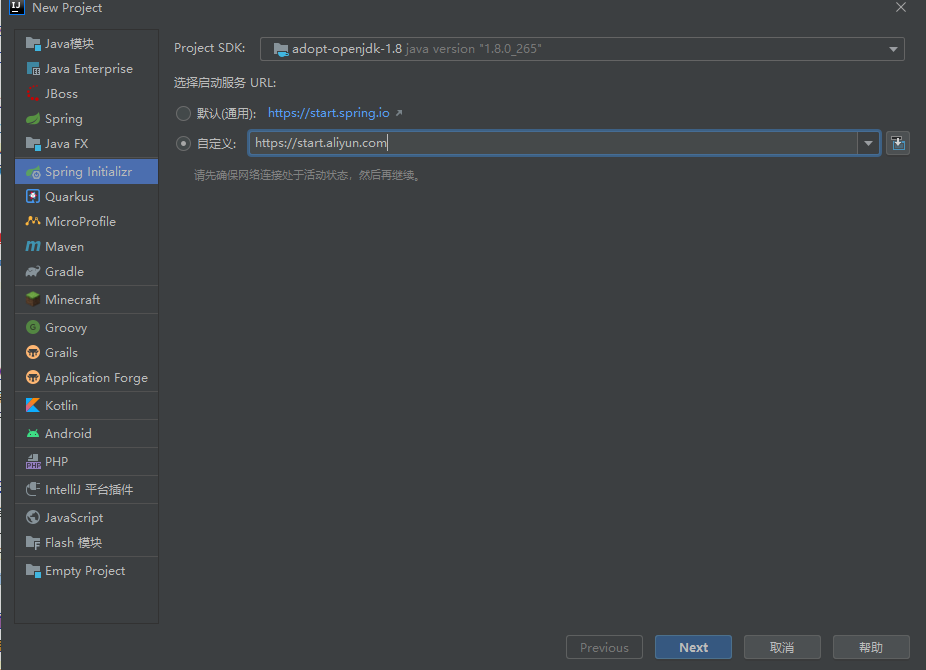
我们照常输入项目组和名称
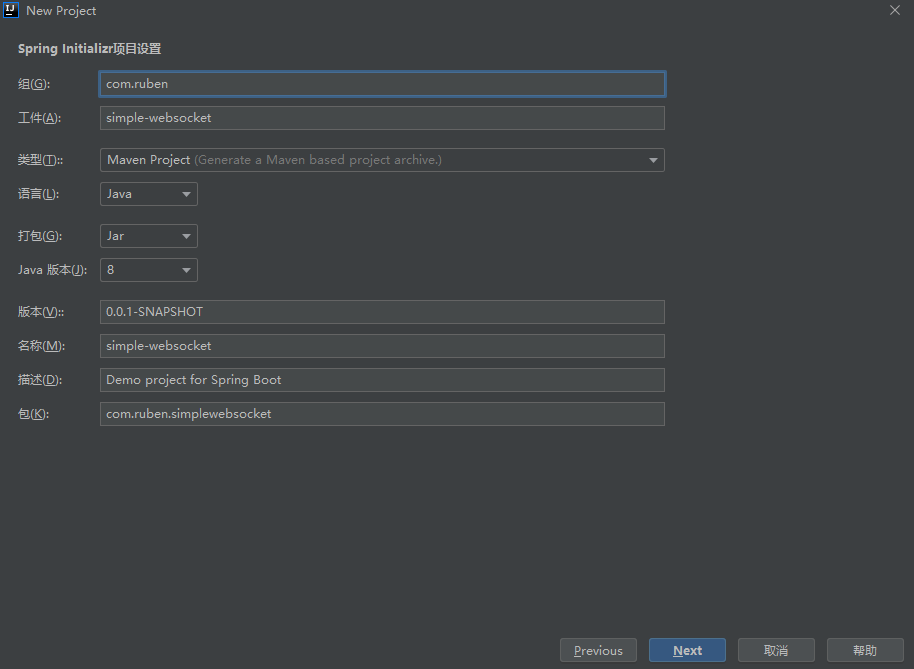
下一步后我们发现除了自带的starter我们还可以选阿里巴巴的
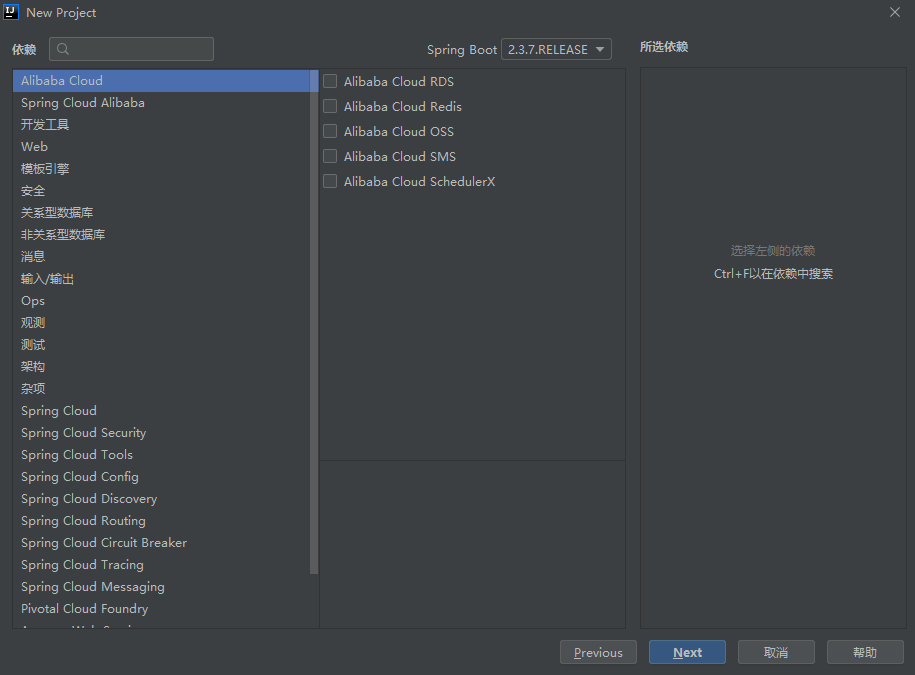
非常实用
相关推荐
2023-12-09
spring-state-machine的action踩坑
善则称人,过则称己,则民不争。——佚名 今天在状态机的action里进行事件触发,发现并没有触发 这是因为在action触发后,state才会进行更改,而不是在state触发后。。。 例如此处我们在action的execute打断点: 可以看到还没有更改状态 如果需要在state触发以后紧接着触发event,则可以放到拦截器里spring-state-machine拦截器处理
2021-03-20
zipkin
懒惰——它是一种对待劳动态度的特殊作风。它以难以卷入工作而易于离开工作为其特点。 —— 杰普莉茨卡娅 引入依赖 123456<!-- zipkin+sleuth 链路追踪+可视化 --><dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-zipkin</artifactId> <version>2.2.0.RELEASE</version></dependency> 注意要把spring-boot-starter-data-redis指定为jedis 123456789101112131415<!-- https://mvnrepository.com/artifact/org.springframework.boot/spring-boot-starter-data-redis --><dependen...
2025-06-07
chunjun
任何教育都比不上灾难的教育。——英狄斯雷利 https://github.com/DTStack/chunjun 纯钧 Chunjun:高性能的分布式数据集成框架在大数据时代,数据的采集、转换和集成是构建数据驱动型系统的核心任务。针对复杂的数据同步需求,Chunjun 提供了一个高性能、易扩展的分布式数据集成框架,专注于实现多源异构数据的高效同步和处理。 Chunjun 是一个开源的分布式数据同步工具,支持多种数据源的读写,适用于实时和批量数据同步场景。它基于 Apache Flink 构建,具有高吞吐量和低延迟的特性,是企业级数据集成的理想选择。 什么是 Chunjun?Chunjun 是一个基于 Flink 的分布式数据集成框架,致力于解决多种数据源之间的数据同步、迁移和集成问题。无论是结构化数据、半结构化数据还是非结构化数据,Chunjun 都能提供高效的解决方案。 它的主要特点包括: 支持多种数据源:涵盖关系型数据库、NoSQL 数据库、消息队列、大数据存储等。 高性能:基于 Flink 的流处理能力,支持实时数据同步和离线批量处理。 易扩展:模块化设计,方便开发...
2020-12-15
读取网络图片时遇到的坑
读书越多,越感到腹中空虚。 ——雪莱 今天在使用java读取网络图片的时候遇到一个问题 图片粘贴到浏览器的地址栏上可以打开 但使用java读取就报400 最后发现原来是url编码问题 把url中的中文、空格或者特殊字符之类的转换一下就好了 1java.net.URLEncoder.encode("www.阿超.com", "utf-8")
2023-12-30
file获取路径区别
男人勤劳家才富,女人节俭纱成布——佚名 这里 12345678910111213import java.io.File;class Scratch { public static void main(String[] args) throws Exception { File file = new File("../scratch.java"); String path = file.getPath(); String absolutePath = file.getAbsolutePath(); String canonicalPath = file.getCanonicalPath(); System.out.println("path:" + path); System.out.println("absolutePath:" + absolutePath); System.out.print...
2020-11-06
stream流分组
前两天补充了博客中写的java8的stream的用法 今天再写个分组的 例如我们下面需要根据奇数偶数分组 可以先新建一个list 1List<Integer> integerList = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 0)); 然后进行分组 1234567Map<Boolean, List<Integer>> collect = integerList.stream().collect(Collectors.groupingBy(data -> data % 2 == 0));List<Integer> evenNumbers = collect.get(true);List<Integer> oddNumber = collect.get(false);System.out.println("data % 2 == 0-----------");evenNumbers.forEach(Syst...
阿超
我的名字叫阿超 年龄25岁 家在北京市 职业是软件开发 每天最晚也会在八点前回家 不抽烟 酒浅尝辄止 晚上十二点上床 保证睡足八个小时 睡前写一篇博客 再做二十分钟俯卧撑暖身 然后再睡觉 基本能熟睡到天亮 像婴儿一样不留下任何疲劳和压力 就这样迎来第二天的早晨 健康检查结果也显示我很正常 我想说明我是一个不论何时都追求内心平稳的人 不拘泥于胜负 不纠结于烦恼 不树立使我夜不能寐的敌人 这就是我在这社会的生活态度
Follow Me公告
This is my Blog