mysql导出导入
发表于|更新于
|浏览量:
成熟意味着停止展示自己并学会隐藏自己。——《失踪的孩子》
官方文档:https://dev.mysql.com/doc/refman/8.0/en/backup-and-recovery.html
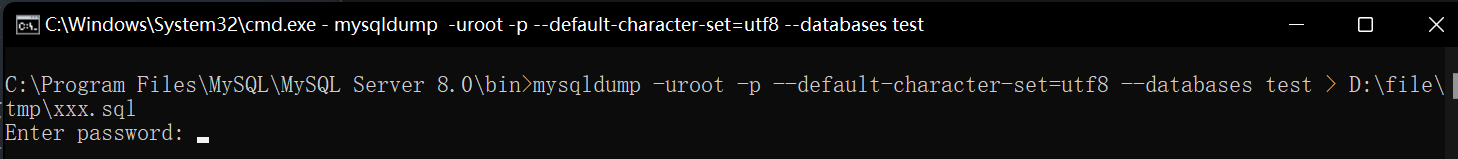
我们可以使用mysql自带的导出工具mysqldump进行导出,我们进入到mysql的bin目录,运行命令
1 | mysqldump -u[用户名] -p --default-character-set=[编码格式] --databases [数据库名] > [导出路径] |
例如我此处的:
1 | mysqldump -uroot -p --default-character-set=utf8 --databases test > D:\file\tmp\xxx.sql |
输入完毕后需要输入密码,我们输入就行了
然后我们可以在mysql客户端中使用source命令,首先连接mysql
1 | mysql -uroot -p |
输入密码后我们切换到想导入的数据库
1 | use test; |
然后使用source
1 | source D:/file/tmp/xxx.sql; |
注意反斜杠转义问题
我们再次show tables;
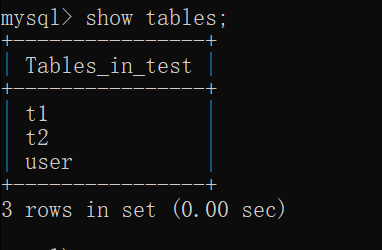
可以看到成功导入
相关推荐
2022-02-06
INSERT ... ON DUPLICATE KEY UPDATE Statement
打开mysql文档,总会有新发现。——碧安瑶 我们在使用INSERT语句时,有时会有这样的需求,不存在就新增,存在就更新 此时我们可以使用INSERT ... ON DUPLICATE KEY UPDATE语句 就像mysql官方文档中提到的那样,我们如果将a列设为UNIQUE唯一索引或者主键时,并且当前表已经存在了a=1的数据,对于这种情况,下面两条sql的结果是相等的 当然如果不满足上方条件,则会新增一条数据 1234INSERT INTO t1 (a,b,c) VALUES (1,2,3) ON DUPLICATE KEY UPDATE c=c+1;UPDATE t1 SET c=c+1 WHERE a=1; 对于InnoDB引擎的表,此处的新增可能会触发自增列,但修改操作不会触发 如果上方的唯一索引再加一个b列,则上方第一条sql和下方sql结果相等 1UPDATE t1 SET c=c+1 WHERE a=1 OR b=2 LIMIT 1; 注意如果此处a=1 or b=2匹配多行,则只会更新一行,所以我们需要避免在有多个唯一索引的表上使用本语法 我们在表内没...
2021-07-29
索引操作
一个人的礼貌是一面照出他的肖像的镜子。——歌德 自己整理的mysql对于索引操作的sql: 12345678910111213141516171819202122232425262728293031323334353637383940CREATE TABLE `user` ( -- 创建表时指定主键索引 `id` BIGINT ( 20 ) PRIMARY KEY NOT NULL COMMENT '主键', `gmt_create` datetime ( 0 ) NOT NULL COMMENT '创建时间', `gmt_modified` datetime ( 0 ) NOT NULL COMMENT '修改时间', `is_delete` TINYINT ( 1 ) NOT NULL DEFAULT 0 COMMENT '逻辑删除字段', `username` VARCHAR ( 32 ) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci U...
2022-12-11
order by field
勿以己才而笑不才——房玄龄 分享一个函数field 首先在mysql内置函数的文档地址能找到这个函数: https://dev.mysql.com/doc/refman/8.0/en/built-in-function-reference.html 这里告诉我们,这个函数可以这么用,寻找第一个参数所在的下标位置,找不到为0: 1234mysql> SELECT FIELD('Bb', 'Aa', 'Bb', 'Cc', 'Dd', 'Ff'); -> 2mysql> SELECT FIELD('Gg', 'Aa', 'Bb', 'Cc', 'Dd', 'Ff'); -> 0 因为此处支持传入表字段 然后我们可以在查询时使用ORDER BY FIELD(字段,已存在的排好序的字段值)
2022-09-25
GraphQL
可怕的不是外貌的丑陋,而是无法与人亲近的内心空虚——科恩 官网:https://graphql.org/ graphql是一个API的查询语言,可以理解为一个规范 正如它官方文档宣传的那样: 定义你的数据规范(数据类型) Describe your data12345type Project { name: String tagline: String contributors: [User]} 描述你想干什么(查询) Ask for what you want12345{ project(name: "GraphQL") { tagline }} 获得预期结果(只获得你需要的结果) Get predictable results12345{ "project": { "tagline": "A query language for APIs" }} 它有多种语言的库...
2026-02-27
ruvector
迁延蹉跎,来日无多,二十丽姝,请来吻我,衰草枯杨,青春易过。——莎士比亚 RuVector:不只是“向量数据库”,更像一套会自我学习的 Agentic AI 操作系统 仓库:ruvnet/ruvector描述(repo description):RuVector is a High Performance, Real-Time, Self-Learning, Vector Graph Neural Network, and Database built in Rust.许可证:MIT一句话 README(更贴近直觉的版本):“会自我学习、自我优化的向量数据库——内置图智能、本地 AI,以及 PostgreSQL。” 很多向量数据库都很强:存向量、建索引、做相似度检索、再配点过滤条件……你用得越久,它还是那套规则;你每次查询,它就每次“照章办事”。 RuVector 的野心不一样:它把“检索”当成一个会成长的过程——它会观察你的使用方式,让结果变得越来越好,并且把“向量、图、LLM、本地推理、PostgreSQL 集成、部署形态(甚至是单文件自启动容器)”尽量收敛到...
2020-08-14
mysql join
首先先放张图 今天聊聊mysql表join连接,其本质是拿主表每条数据取出来和子表每行数据进行循环比较,如果满足则返回,不满足返回null 首先是内连接 两者之间取交集,两边都满足返回,不满足不返回 语法很简单 1234567SELECT * FROM tb_goods a INNER JOIN tb_goods_desc b WHERE a.id = b.goods_id 其中,INNER可以省略掉只写个JOIN 然后是左外连接 左外连接,此时可以理解为理解 左表为主表,右表为子表。在条件不满足时,左表数据存在,右表数据为null 简单来说就是结果集包含左表所有行,右表不匹配则为null 12345SELECT * FROM sp_user a LEFT OUTER JOIN tb_seller b ON a.seller_id = b.seller_id 其中,OUTER可省略 反向操作一波就是右外连接 1234567SELECT * FROM tb_seller a RIGHT OUTER JOIN sp_user b ON a.seller_id = b.sell...

阿超
我的名字叫阿超 年龄25岁 家在北京市 职业是软件开发 每天最晚也会在八点前回家 不抽烟 酒浅尝辄止 晚上十二点上床 保证睡足八个小时 睡前写一篇博客 再做二十分钟俯卧撑暖身 然后再睡觉 基本能熟睡到天亮 像婴儿一样不留下任何疲劳和压力 就这样迎来第二天的早晨 健康检查结果也显示我很正常 我想说明我是一个不论何时都追求内心平稳的人 不拘泥于胜负 不纠结于烦恼 不树立使我夜不能寐的敌人 这就是我在这社会的生活态度
Follow Me公告
This is my Blog